Proxmox VE 運作非常穩定,但即便如此,再怎麼樣穩定的系統仍然有機會遇到問題。
舉個例子,我有使用 LibreNMS 對 Proxmox VE 的各個系統服務做定期監測,但每天早上六點多都會有 spiceproxy 這個服務異常警報,我想要查看 spiceproxy 這個 PVE 相關服務的記錄,該怎麼做呢?
方法一
在 Linux 系統中,大部份的服務都會由 syslog 服務統一處理,路徑在 /var/log/ 裡。
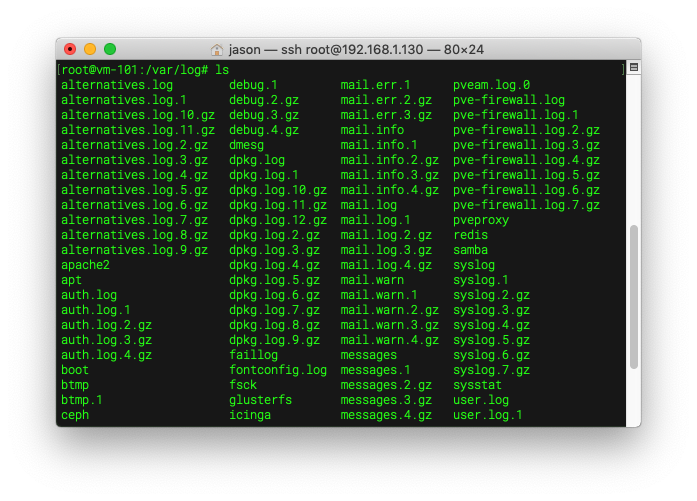
以 spiceproxy 來說,記錄在 /var/log/syslog 裡面,可以使用 cat 指令列出,再搭配 grep 指令做篩選。
查看 spice 相關記錄
cat /var/log/syslog | grep spice註:如要查詢其它服務,將 grep 後的字串代換即可,例如 pvedaemon。
執行指令以後,可以得出以下內容:
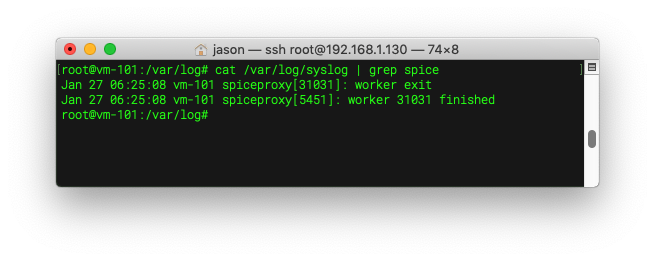
列是列出來了,可是怎麼只有今天的呢?
因為在於系統啟動了「Logrotate」的機制,以每天為一期將記錄檔切割出去,切割出去的會於下一次 Logrotate 時進行壓縮。
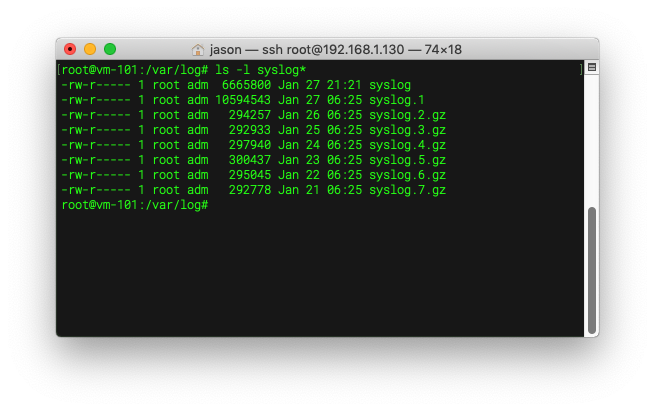
所以若要看前一期的內容,請查看 syslog.1 這個檔案。
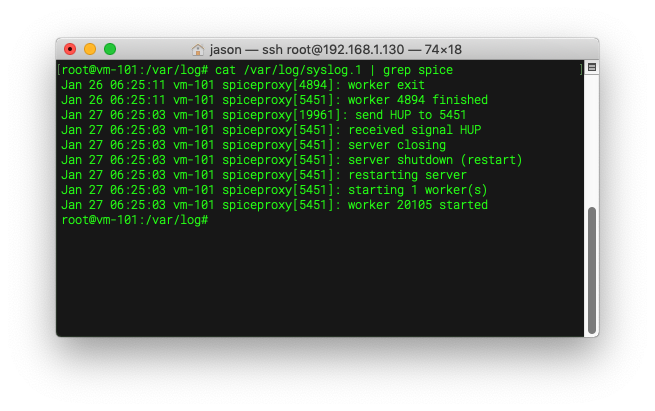
知道怎看是一回事,但用起來有些困擾,如果要看更早的還需要先解開 .gz 檔案,有沒有更簡單的方法?
方法二
其實,在 WebUI 就有簡單方便的功能了,請點選 [Node 節點] -> [System 系統] -> [spiceproxy] -> [Syslog]。
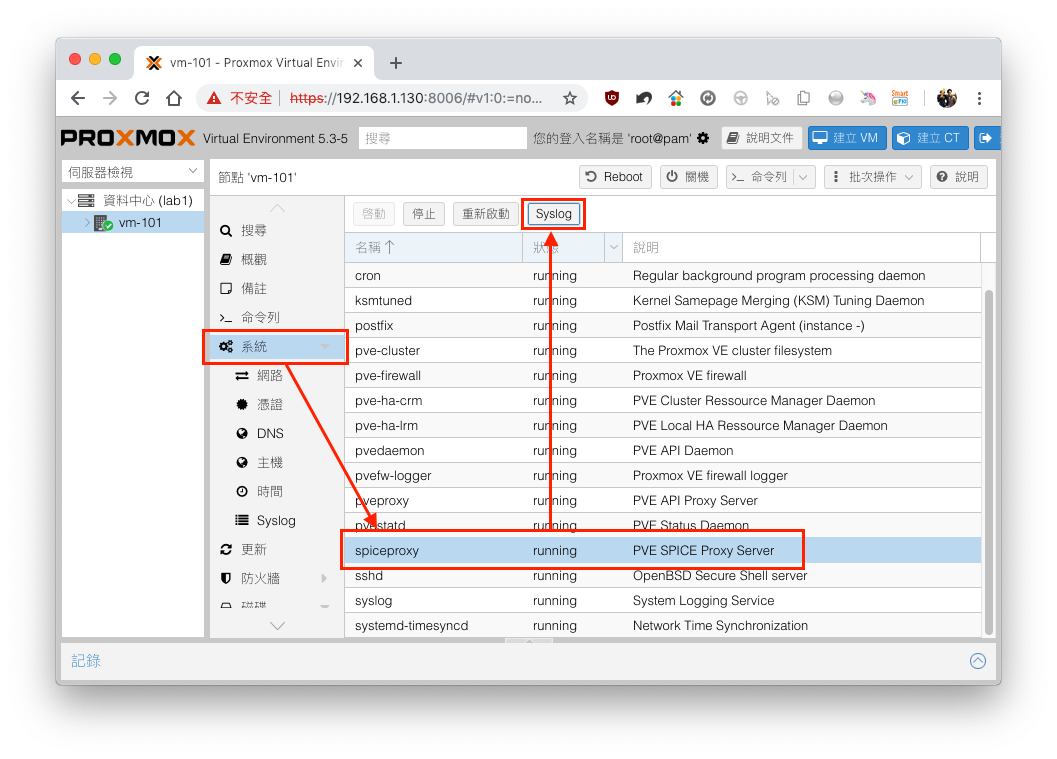
點選以後,就可以看到這個記錄清單,還可以手動調整起迄日期方便查詢。
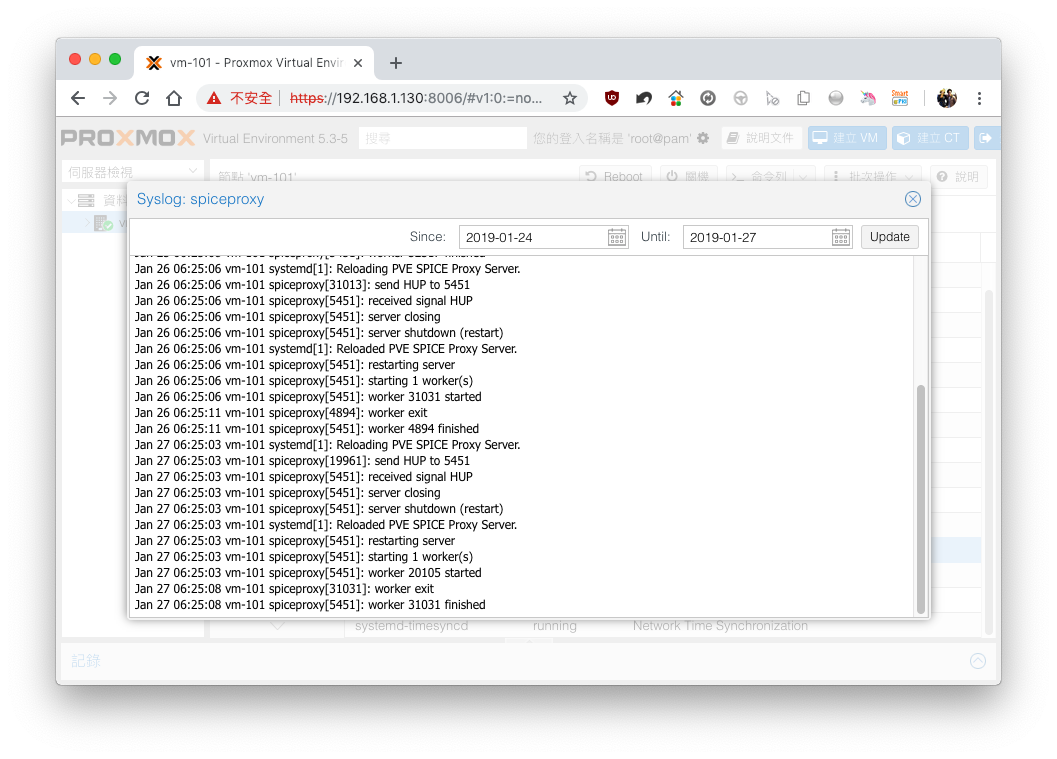
提醒,這裡可以查詢的日期範圍,一樣會受限於 Logrorate 的最大天數。
方法三
在系統越來越多的情況下,統一搜集做分析查看,甚至提供告警功能,對系統管理員的負擔可以大大減輕,而且可以更長期的保存,做為日後調閱的依據。
我的作法是採用 LibreNMS 做為中央收集器,並在收到內容後,依據制定的 Rule 規則進行警報發送。
PVE 系統內所使用的 Rsyslog 套件,可以修改設定,把事件直接丟到遠端的 Syslog Server 做處理。
請開啟 /etc/rsyslog.conf 檔案,並加入一行設定,指向 LibreNMS 位置,以 192.168.1.68 為例:
加入 syslog 記錄轉送
*.* @@192.168.1.68:514存檔後,請重新啟用 syslog 服務生效,接下來可以登入 LibreNMS 的介面進行查看。
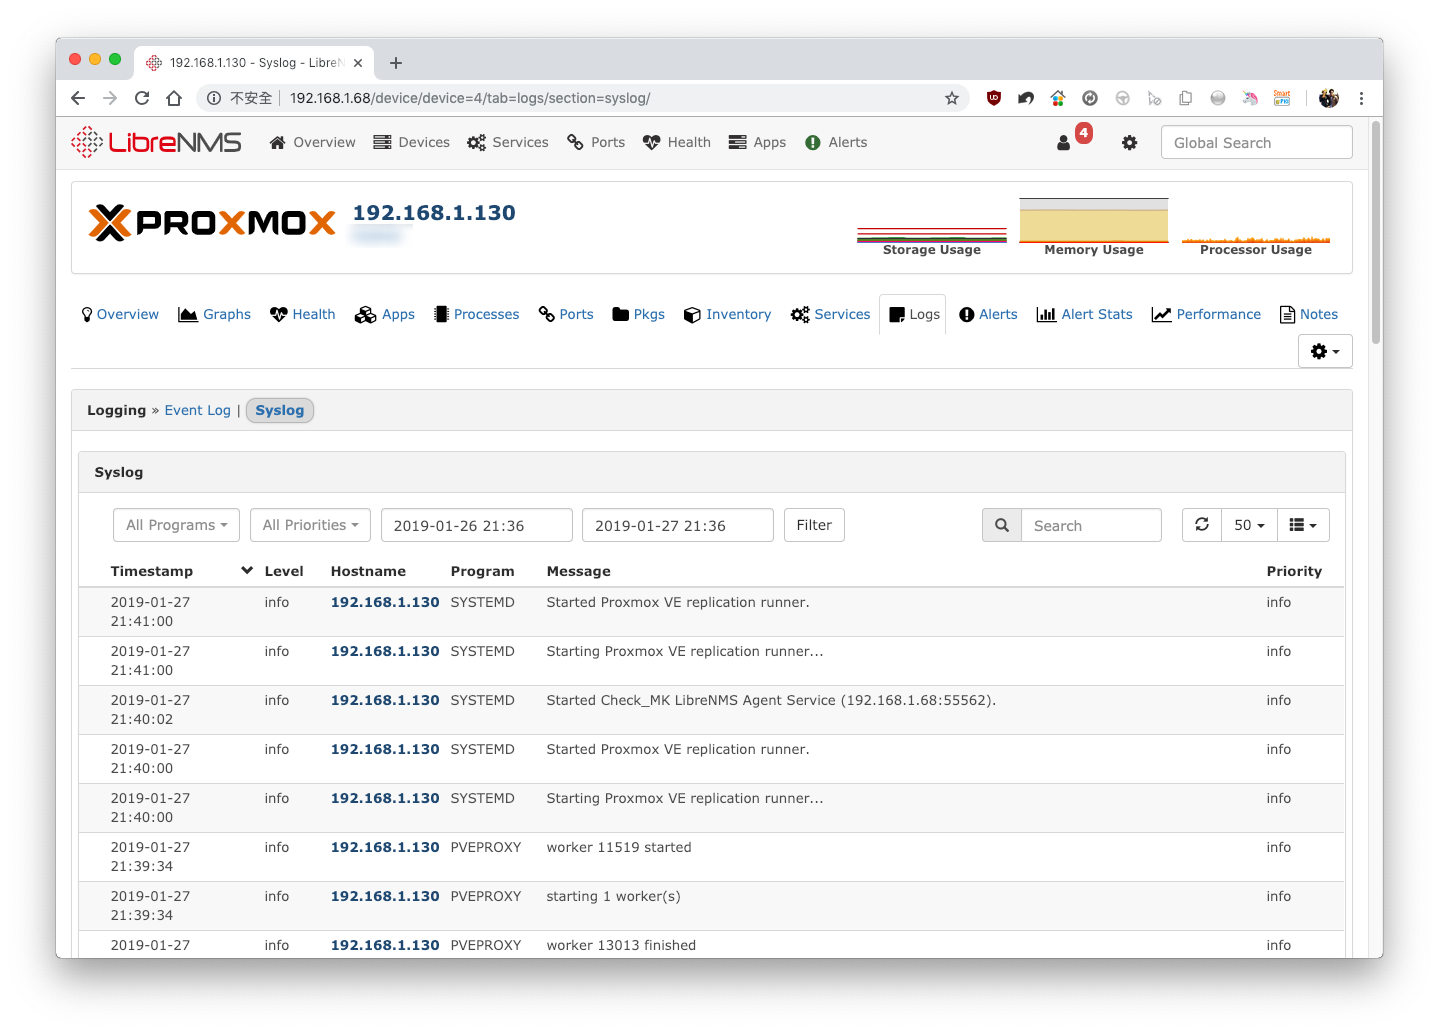
LibreNMS 可以搜集主機的各種效能資訊,若再利用 LibreNMS 做為 Syslog 伺服器,可以更全面的掌握主機的事件狀況,相當方便。
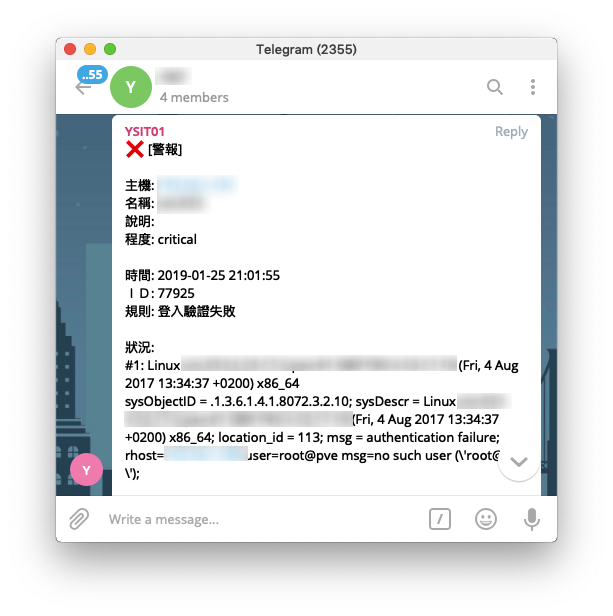
上圖就是一個應用案例,若 LibreNMS 的 Syslog 收取到有登入驗證失敗的事件,LibreNMS 上的 Alert Rule 警報規則就會自動以 Telegram 推播發送給相關人員,管理者即能立刻掌握狀況。
結論
講完了三種方法,回頭看看為什麼先前提到 spiceproxy 會異常呢?
每天早上都會收到 LibreNMS 的警報推播:
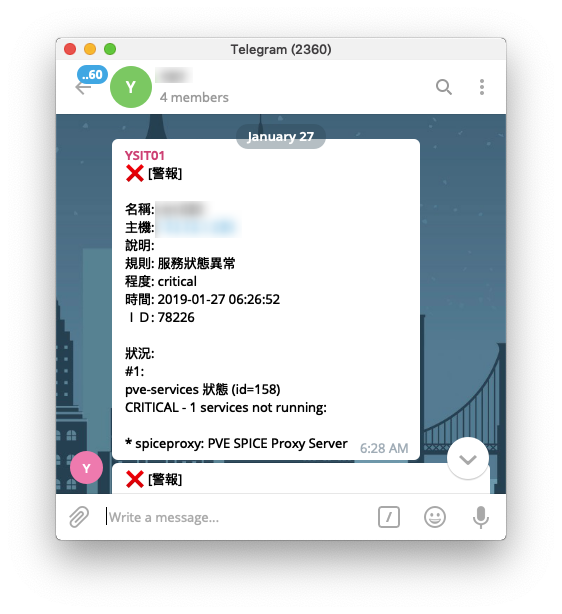
一開始以為是個案,後來發現每一個 PVE 節點在每一天都有一樣的狀況,那可要好好查查。
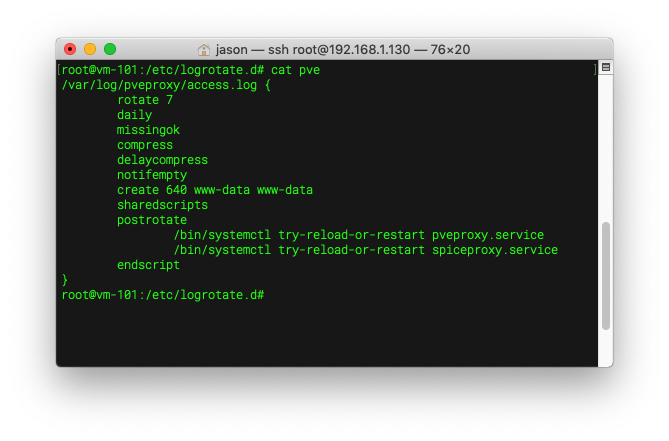
經過了解,原來是 Logroate 時,會把 pveproxy、spiceproxy 這兩個服務重新啟動,推測是因為這兩個服務沒有支援 hup 功能,所以需要將服務重啟才避免咬住 log 檔。
參考資料
- logrotate(8) - Linux man page
https://linux.die.net/man/8/logrotate - rsyslogd(8) - Linux manual page
- Service daemons - Proxmox VE
https://pve.proxmox.com/wiki/Service_daemons - [議程簡報]LibreNMS 企業實戰經驗分享
http://blog.jason.tools/2018/11/librenms-slideshare.html - kill -HUP pid - 小菜鸟的天地 - CSDN博客
https://blog.csdn.net/zhuying_linux/article/details/7031573